از ChatGPT میخواهید گزارش فروش ماه گذشته را خلاصه کند. جواب روان و مرتب است و لحنش مطمئن. اما وسط آن عددی میبینید که هرگز در گزارش شما نبوده است.
این تجربه برای بسیاری از مدیران آشناست. ابزار شگفتانگیز است، ولی نمیدانید چقدر میشود به آن تکیه کرد. دلیلش این است که معمولاً کسی توضیح نداده این ابزارها واقعاً چطور کار میکنند.
در این مقاله بدون کد، بدون فرمول و فقط با مثالهای روزمره میگوییم مدل زبانی بزرگ چیست، چرا گاهی اشتباه میکند و چطور میتوانید در کسبوکارتان امن و مؤثر از آن استفاده کنید.
مدل زبانی بزرگ چیست؟ در یک جمله
مدل زبانی بزرگ (LLM) برنامهای است که با خواندن حجم عظیمی از متن، الگوهای زبان را یاد گرفته و میتواند برای هر درخواست شما متنی تازه و مرتبط بنویسد.
ChatGPT، Claude و Gemini همگی از این نوعاند. این ابزارها «فکر» نمیکنند، «جستجو» هم نمیکنند. متن میسازند. فهمیدن همین تفاوت نصف راه استفادهی درست است.
LLM چگونه کار میکند؟
مرحلهی اول: یادگیری از متنهای بسیار زیاد
به دانشجویی فکر کنید که کتابها، مقالهها و گفتوگوهای بیشماری خوانده است. او قاعدههای دستور زبان را حفظ نمیکند، اما از بس نمونه دیده، حس میکند چه جملهای بعد از چه جملهای طبیعی است. به این مرحله «آموزش» (training) میگویند.
مرحلهی دوم: تصحیح با بازخورد انسان
دانشجوی ما هنوز میتواند بیربط یا نامناسب جواب بدهد. پس مربیانی پاسخهایش را ارزیابی میکنند: این یکی مفید بود، آن یکی نه، این یکی مؤدبانه نبود. مدل از این بازخورد یاد میگیرد پاسخهایی بدهد که شبیه یک دستیار مفید باشد. جزئیات این مراحل در هر شرکت فرق دارد و مستندات رسمی OpenAI، Anthropic و Google آنها را توضیح دادهاند.
پاسخدادن: حدس زدن قطعهی بعدی، قدم به قدم
تکمیل خودکار پیامک گوشی را دیدهاید؟ شما مینویسید «فردا ساعت» و گوشی پیشنهاد میدهد «۱۰». مدل زبانی بزرگ همین کار را میکند، اما با خواندن و تجربهای بسیار بیشتر و با درک دقیقتر از کل متن.
مدل یک قطعهی کوچک متن (توکن) را پیشبینی میکند، آن را به متن اضافه میکند و دوباره بر اساس همهی آنچه تا اینجا هست، قطعهی بعدی را انتخاب میکند. پاسخ کامل، حاصل چند صد بار تکرار همین حدسهای پشت سر هم است.
(ایدهی فنی پشت این فناوری در مقالهی پژوهشی معروف «Attention Is All You Need» آمده است. برای استفادهی کسبوکاری لازم نیست آن را بخوانید.)
توکن و پنجرهی متنی: چرا مدل همهچیز را یکجا نمیبیند؟
توکن قطعهی کوچکی از متن است؛ گاهی یک کلمه، گاهی بخشی از کلمه یا یک علامت نگارشی. مدل متن را بهصورت توکن میخواند و مینویسد.
پنجرهی متنی (context window) یعنی بیشینهی متنی که مدل در هر گفتوگو میتواند همزمان پیش چشم داشته باشد. میزی را تصور کنید که فقط چند صفحه روی آن جا میشود. هر چه روی میز نباشد، برای مدل وجود ندارد.
اندازهی این پنجره در مدلهای مختلف فرق میکند و بهسرعت در حال تغییر است، پس عدد مشخصی نمینویسیم. برای عدد روز به مستندات رسمی هر مدل نگاه کنید. اما نکتهی عملی ثابت است:
- یک قرارداد یا گزارش بسیار طولانی ممکن است کامل در پنجره جا نشود.
- در گفتوگوهای طولانی، بخشهای ابتدایی ممکن است از دید مدل بیرون بیفتند.
- مدل ممکن است جزئیاتی را از وسط یک متن بلند نادیده بگیرد. برای سندهای مهم، خروجی را با متن اصلی مقایسه کنید.
چرا مدل گاهی چیزی از خودش میسازد؟
توهم (Hallucination)
هدف مدل «درست گفتن» نیست؛ «محتملترین ادامهی متن» است. دانشجویی را تصور کنید که آن فصل کتاب را نخوانده، اما چون عادت دارد روان جواب بدهد، پاسخی قانعکننده میسازد. نتیجه میتواند عددی، نقلقولی یا منبعی باشد که وجود ندارد. به این پدیده «توهم» میگویند. شدتش بسته به مدل و موضوع فرق میکند، ولی کاملاً حذفشده نیست.
تاریخ قطع دانش
آموزش مدل در یک تاریخ تمام میشود. مثل مجلهای است که در یک روز چاپ شده؛ هر اتفاقی بعد از آن در آن نیست، مگر اینکه ابزار جستجو یا منبع دیگری به مدل داده شود.
اطلاعات شرکت شما را نمیداند
مدل مثل کارمند تازهواردی است که روز اول آمده: باهوش و ماهر در نوشتن، اما نه مشتریهای شما را میشناسد، نه قیمتها، نه رویههای داخلی. اگر اینها را به او ندهید، یا میگوید نمیداند یا بدتر، حدس میزند.
کسبوکارها این محدودیتها را چطور برطرف میکنند؟
خبر خوب این است که هر سه محدودیت راهحل مهندسی دارند. مدل را عوض نمیکنید؛ آن را به منابع درست وصل میکنید.
۱. دادن اسناد خودتان به مدل (RAG)
در روش تولید تقویتشده با بازیابی (RAG)، وقتی کسی سؤالی میپرسد، سیستم اول مرتبطترین بخشها را از اسناد شما پیدا میکند و کنار سؤال به مدل میدهد. مثل این است که قبل از پاسخ، کتاب راهنمای شرکت را باز کنید و صفحهی درست را جلوی او بگذارید. جواب مبتنی بر سند شماست و میتوان منبعش را نشان داد.
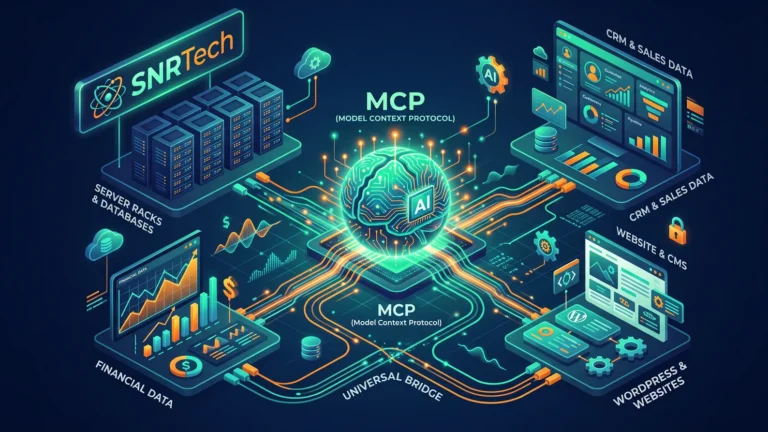
۲. اتصال مدل به سیستمهای شما (MCP)
گاهی سند کافی نیست و مدل باید به دادهی زنده دسترسی داشته باشد؛ مثلاً موجودی انبار یا وضعیت سفارش. پروتکل MCP راهی استاندارد برای وصلکردن مدل به نرمافزارها و دادههای سازمان است. جزئیاتش را در مقالهی پروتکل MCP چیست و چرا برای کسبوکار شما مهم است؟ خواندهاید یا میتوانید بخوانید.
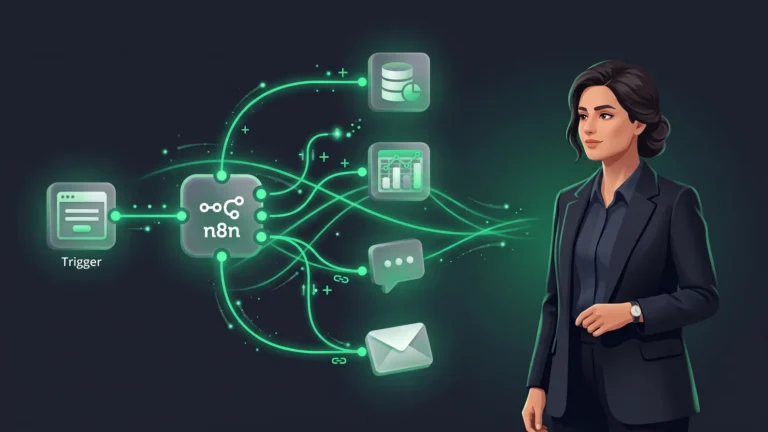
۳. قرار دادن مدل در گردشکار خودکار (n8n)
مدل بهتنهایی منتظر میماند کسی از او چیزی بپرسد. وقتی آن را در یک گردشکار خودکار میگذارید، خودش وارد عمل میشود: ایمیل مشتری میرسد، مدل آن را دستهبندی میکند، پیشنویس پاسخ مینویسد و کار به فرد مناسب میرسد. ابزارهایی مثل n8n این اتصالها را ممکن میکنند؛ در مقالهی n8n چیست؟ اتوماسیون کسبوکار بدون کار تکراری بیشتر دربارهاش بخوانید.
اگر نمیدانید کدام ترکیب برای کسبوکار شما مناسب است، تیم سپهر نوآوران رایکا میتواند با شما بررسی کند. هوش مصنوعی و عاملهای هوشمند بخش مهمی از محصولاتی است که میسازیم.
هوش مصنوعی برای کسبوکار: کاربردهای عملی
مدلهای زبانی در کارهایی که با متن سروکار دارند بیشترین کمک را میکنند:
- پشتیبانی مشتری: پاسخ به پرسشهای تکراری بر اساس اسناد شما و آمادهکردن پیشنویس پاسخ برای کارشناس، تا مشتری زودتر جواب بگیرد.
- تولید پیشنویس محتوا: ایمیل، توضیح محصول و متن شبکههای اجتماعی. نسخهی نهایی را انسان تأیید میکند.
- خلاصهسازی گزارشها: هر گزارش بلند به چند بند قابلخواندن تبدیل میشود و وقت مدیر برای تصمیم آزاد میماند.
- جستجو در اسناد داخلی: بهجای گشتن در پوشهها، سؤال خود را به زبان ساده میپرسید.
- ورود داده: استخراج اطلاعات از فاکتور، فرم یا ایمیل و واردکردن آن در نرمافزار، با کنترل انسانی روی موارد حساس.
قاعدهی کلی: هر جا یک اشتباه کوچک گران تمام نمیشود یا انسان نتیجه را بازبینی میکند، شروع کنید. برای تصمیمهای مالی و حقوقی، مدل دستیار است، نه مرجع نهایی.
سابقهی ما: [تعداد پروژههای هوش مصنوعی انجامشده توسط سپهر نوآوران رایکا] — [توضیح یک پروژهی واقعی هوش مصنوعی و نتیجهی تأییدشدهی آن].
حریم خصوصی و امنیت: پیش از ارسال داده چه چیزی را بررسی کنیم؟
وقتی متنی را برای یک سرویس هوش مصنوعی میفرستید، آن متن روی سرورهای ارائهدهنده پردازش میشود. اینکه چه مدت نگهداری شود، چه کسی ببیند و آیا برای بهبود مدل استفاده شود، به سرویس و نوع اشتراک بستگی دارد. نسخهی رایگان و نسخهی سازمانی ممکن است شرایط متفاوتی داشته باشند. پس فرض نکنید؛ سیاست رسمی ارائهدهنده را بخوانید.
پیش از استفاده با دادهی مشتری یا اطلاعات مالی این فهرست را مرور کنید:
- آیا دادهی شما برای آموزش مدل استفاده میشود و میتوان آن را غیرفعال کرد؟
- داده چه مدت نگهداری میشود و چگونه حذف میشود؟
- داده کجا ذخیره و پردازش میشود و آیا با قوانین حفظ دادهی کشور و صنعت شما سازگار است؟
- چه کسانی از کارکنان به چه دادهای دسترسی دارند؟ دسترسی مدل را هم مثل دسترسی یک کارمند محدود کنید.
- آیا میتوانید پیش از ارسال، اطلاعات شناسایی مثل نام، شمارهی حساب و کد ملی را حذف یا پنهان کنید؟
- آیا سیاست داخلی روشنی دارید که به کارکنان بگوید چه چیزی را نباید در ابزارهای عمومی بنویسند؟
سؤالات متداول
آیا هوش مصنوعی واقعاً میفهمد؟
پاسخ ساده نیست و پژوهشگران هم هنوز دربارهی معنای «فهمیدن» بحث دارند. آنچه میتوان با اطمینان گفت این است که مدلها الگوهای زبان را بسیار خوب یاد گرفتهاند و در بسیاری از کارها مثل کسی که فهمیده رفتار میکنند. اما مثل انسان تجربهی دنیای واقعی ندارند و ممکن است با لحن مطمئن اشتباه کنند. برای کار، آن را ابزاری قدرتمند بدانید که باید نتیجهاش بازبینی شود.
آیا اطلاعات من امن است؟
بستگی دارد. هیچ پاسخ «بله» یا «نه»ی کلی وجود ندارد. امنیت به سرویس، نوع اشتراک، تنظیمات، قرارداد و نحوهی اتصال شما بستگی دارد. برخی سرویسها برای کسبوکارها شرایط محافظتشدهتری ارائه میکنند، اما باید خودتان آن را بخوانید و بسنجید. اطلاعات حساس را بیملاحظه در ابزارهای عمومی نگذارید و برای دادهی مهم، معماری مناسب طراحی کنید.
آیا هوش مصنوعی جای کارمندان را میگیرد؟
هیچکس آینده را دقیق نمیداند، پس وعدهی قطعی نمیدهیم. آنچه امروز دیده میشود این است که مدلها بیشتر بخشهایی از کار را سریعتر میکنند، مثل نوشتن پیشنویس و خلاصهسازی، نه کل یک شغل را. قضاوت، مسئولیتپذیری و ارتباط انسانی هنوز با آدمهاست. معقولترین رویکرد این است که کارهای تکراری را به ابزار بسپارید و کارکنان را برای کار با آن آموزش بدهید.
از کجا شروع کنیم؟
یک فرایند تکراری و کمریسک انتخاب کنید، مثلاً پاسخ به پرسشهای متداول مشتری. با یک آزمایش کوچک شروع کنید، نتیجه را بسنجید و بعد گسترش دهید.
واژهنامه
- مدل زبانی بزرگ (LLM): مدلی که از حجم زیادی متن، الگوهای زبان را یاد گرفته و متن تولید میکند.
- توکن (Token): قطعهی کوچکی از متن که مدل با آن کار میکند.
- پنجرهی متنی (Context window): بیشینهی متنی که مدل همزمان میتواند ببیند.
- آموزش (Training): مرحلهای که مدل از متنهای فراوان الگوها را یاد میگیرد.
- تنظیم دقیق (Fine-tuning): ادامهی آموزش مدل با دادههای خاص برای تخصصیشدن در یک کار یا سبک.
- توهم (Hallucination): تولید اطلاعات نادرست یا ساختگی با لحنی مطمئن.
- RAG: روشی که در آن اسناد مرتبط پیدا و همراه سؤال به مدل داده میشود.
- پرامپت (Prompt): دستور یا متنی که شما به مدل میدهید.
قدم بعدی: هوش مصنوعی را امن و هدفمند وارد کار کنید
حالا میدانید مدل زبانی بزرگ چیست: ابزاری قدرتمند برای تولید و پردازش متن که نه همهچیز میداند و نه خطاناپذیر است. با اسناد درست، اتصال مناسب و کنترل انسانی، میتواند وقت تیم شما را آزاد کند. بدون آنها، ممکن است اشتباههایی بسازد که دیر متوجهشان شوید.
برای بررسی اینکه کدام فرایند شما برای شروع مناسب است و چطور دادههایتان را حفظ کنید، با ما صحبت کنید. مشاورهی اولیه رایگان است و بدون تعهد.
دیدگاه خود را بنویسید